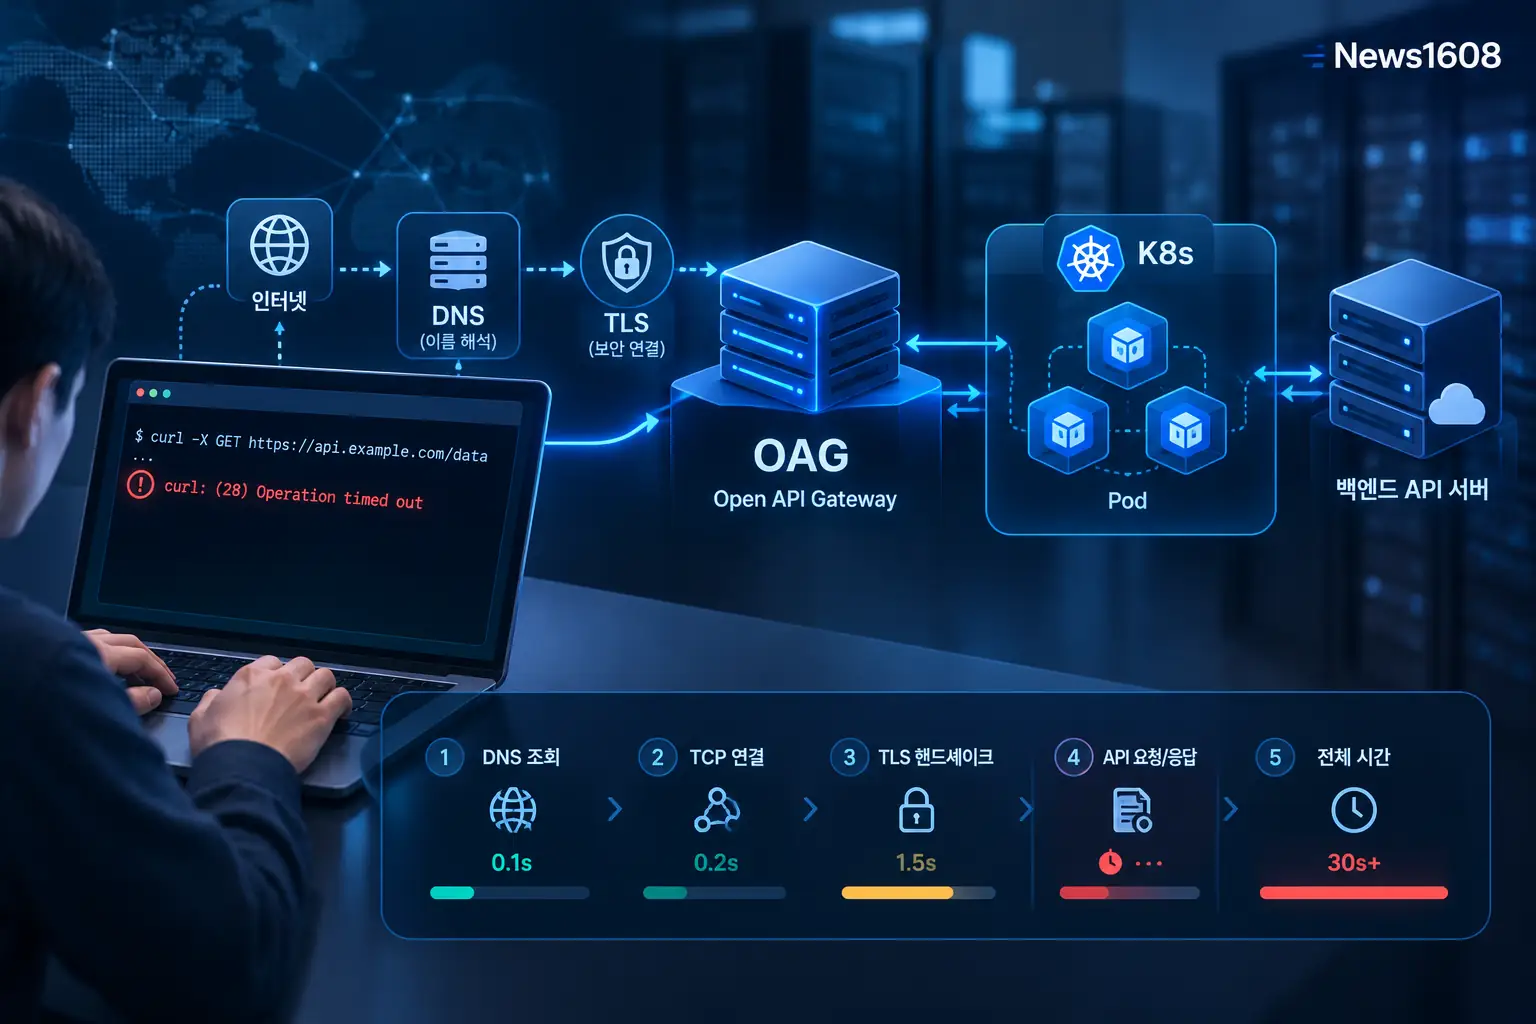
AI 모델 연동, 금융권 API, 공공데이터, 마이데이터 등 서로 다른 시스템을 연결하는 API 환경에서는 네트워크 지연과 타임아웃 문제가 자주 발생합니다. 그중 개발자들이 많이 접하는 오류가 cURL error 28: Operation timed out입니다.
cURL 28은 단순히 “서버가 다운됐다”는 의미가 아닙니다. cURL이 설정된 시간 제한 조건에 도달했다는 뜻으로, DNS 이름 해석부터 TCP 연결, TLS 핸드셰이크, API Gateway, 백엔드 서버 처리까지 여러 구간을 점검해야 정확한 원인을 찾을 수 있습니다.
이번 글에서는 REST API 연동 과정에서 발생하는 cURL 28 타임아웃 오류의 의미를 살펴보고, OAG(Open API Gateway)와 Kubernetes 환경을 포함해 실무에서 활용할 수 있는 네트워크 디버깅 5단계를 정리합니다.
cURL 28 오류는 무엇인가?
cURL의 CURLE_OPERATION_TIMEDOUT은 오류 코드 28입니다.
공식 cURL 문서에서는 이를 설정된 timeout 조건에 따라 작업에 허용된 시간이 초과된 경우 발생하는 오류로 설명합니다. 따라서 cURL 28이라는 오류 코드만으로 “DNS 문제다”, “서버 문제다”, “API Gateway 문제다”라고 단정할 수는 없습니다.
예를 들어 다음과 같은 요청을 실행했다고 가정해보겠습니다.
curl --max-time 30 https://api.example.com/data30초 안에 요청이 완료되지 않으면 cURL이 timeout을 발생시킬 수 있습니다.
중요한 것은 30초 동안 어느 구간에서 시간이 소비됐는지를 확인하는 것입니다.
DNS 조회가 느렸을 수도 있고, TCP 연결이 지연됐을 수도 있습니다. TLS 연결은 정상적으로 끝났지만 API Gateway 이후 백엔드 서버의 응답이 늦었을 수도 있습니다.
따라서 cURL 28 문제는 “서버가 죽었는지”부터 확인하기보다는 통신 과정에서 어느 단계가 느려졌는지 측정하는 것이 출발점입니다.
OAG 환경에서 cURL 28이 발생하는 구조
금융권이나 대규모 기업의 API 환경에서는 일반적으로 다음과 같은 통신 구조를 생각할 수 있습니다.
Client → DNS → TCP/TLS → OAG(API Gateway) → Kubernetes/서비스 → Backend API → DB 또는 외부 시스템
이 구조에서 어느 한 구간이라도 지연되면 최종적으로 클라이언트에서 timeout이 발생할 수 있습니다.
특히 OAG라는 명칭은 조직이나 솔루션에 따라 의미가 달라질 수 있지만, 여기서는 Open API Gateway를 의미하는 일반적인 표현으로 사용하겠습니다.
API Gateway에서는 인증·인가, 라우팅, Rate Limit, 로깅, 정책 적용 등의 작업이 수행될 수 있기 때문에 Gateway 자체의 처리 지연이나 뒤쪽 서비스의 응답 지연도 함께 확인해야 합니다.
OAG 네트워크 디버깅 5단계
1단계. 연결 시간과 전체 시간을 분리해서 확인한다
가장 먼저 해야 할 일은 연결 단계에서 문제가 발생했는지, 연결 이후 서버 응답이 늦어진 것인지 구분하는 것입니다.
cURL에는 이를 확인할 수 있는 여러 측정값이 있습니다.
| 측정값 | 의미 | 주요 확인 대상 |
|---|---|---|
time_namelookup | DNS 이름 해석까지 걸린 시간 | DNS/CoreDNS |
time_connect | TCP 연결까지 걸린 시간 | 네트워크·방화벽 |
time_appconnect | TLS/SSL 연결 완료까지 걸린 시간 | TLS·인증서·보안장비 |
time_starttransfer | 첫 번째 응답 데이터가 도착하기까지의 시간 | Gateway·백엔드 |
time_total | 전체 요청이 완료될 때까지의 시간 | 전체 통신 구간 |
cURL 공식 문서에서도 --connect-timeout은 연결 단계에 대한 제한이며, DNS와 TCP/TLS 또는 QUIC 핸드셰이크가 포함된 연결 단계의 시간을 제한합니다. 반면 --max-time은 각각의 전송이 진행되는 최대 시간을 설정합니다.
실제 시간을 확인하려면 다음과 같이 실행할 수 있습니다.
curl -o /dev/null -s -w \
"DNS:%{time_namelookup}\nTCP:%{time_connect}\nTLS:%{time_appconnect}\nTTFB:%{time_starttransfer}\nTOTAL:%{time_total}\n" \
https://api.example.com
예를 들어 결과가 다음과 같다고 가정해보겠습니다.
DNS:0.020
TCP:0.040
TLS:0.080
TTFB:29.500
TOTAL:30.100
이 경우 DNS나 TCP, TLS보다는 첫 응답이 오기 전 단계에서 상당한 시간이 소요됐는지를 우선적으로 살펴볼 필요가 있습니다.
반대로 DNS 시간이 비정상적으로 길다면 애플리케이션 서버를 먼저 의심하기보다 DNS 구간을 점검해야 합니다.
즉, cURL 28의 원인을 찾는 첫 번째 원칙은 “전체 시간이 아니라 구간별 시간을 측정하는 것”입니다.
2단계. Kubernetes DNS와 CoreDNS를 확인한다
Kubernetes 환경에서는 DNS 문제가 API timeout으로 이어지는 경우도 있기 때문에 간헐적인 장애가 발생한다면 DNS부터 확인할 필요가 있습니다.
Kubernetes에서는 CoreDNS가 클러스터 DNS 역할을 수행할 수 있으며, 공식 디버깅 가이드에서도 Pod 내부의 /etc/resolv.conf, DNS Service, CoreDNS Pod 상태, 로그 등을 단계적으로 확인하도록 안내하고 있습니다.
먼저 다음과 같이 DNS 설정을 확인할 수 있습니다.
kubectl exec -it <pod-name> -- cat /etc/resolv.conf이후 DNS 조회가 정상적으로 되는지도 확인합니다.
kubectl exec -it <pod-name> -- nslookup api.example.comCoreDNS Pod 상태도 확인할 수 있습니다.
kubectl get pods -n kube-system -l k8s-app=kube-dns필요하다면 CoreDNS 로그도 확인합니다.
kubectl logs -n kube-system -l k8s-app=kube-dnsKubernetes 공식 문서에서도 DNS 문제가 발생했을 때 resolv.conf, CoreDNS Pod, DNS Service, EndpointSlice, CoreDNS 로그 등을 순차적으로 확인하는 방법을 제시합니다.
특히 ndots나 search domain 설정은 DNS 조회 횟수와 경로에 영향을 줄 수 있으므로 성능 문제가 의심될 경우 확인할 수 있습니다.
다만 특정 환경에서 무조건 IPv6 AAAA 조회를 끄거나 ndots 값을 변경하는 것이 정답은 아닙니다.
DNS 설정을 변경하기 전에 실제 DNS 조회 시간과 resolv.conf, CoreDNS 상태를 먼저 확인하는 것이 안전합니다.
3단계. OAG의 Rate Limit과 Throttling을 확인한다
API Gateway 환경에서는 많은 요청을 한꺼번에 처리하지 않기 위해 Rate Limit 또는 Throttling 정책을 적용하는 경우가 많습니다.
예를 들어 특정 API가 초당 100건의 요청을 허용하도록 설정되어 있는데 클라이언트가 그보다 많은 요청을 보내면 Gateway 정책에 따라 요청이 제한될 수 있습니다.
하지만 여기서 중요한 점이 있습니다.
Rate Limit을 초과했다고 해서 반드시 cURL 28이 발생하는 것은 아닙니다.
Gateway나 API 관리 시스템의 정책에 따라 429 Too Many Requests 같은 HTTP 응답을 반환할 수도 있고, 별도의 오류 코드나 지연으로 처리할 수도 있습니다.
따라서 다음과 같은 정보를 함께 확인해야 합니다.
- HTTP Status Code
- API Gateway 로그
- Rate Limit 정책
- 요청량(TPS)
- Queue 대기시간
- Gateway 처리시간
Retry-After또는 관련 응답 헤더- 백엔드 API의 처리시간
예를 들어 429 응답이 발생한다면 단순한 네트워크 timeout으로 판단하기보다는 호출량과 API Gateway의 정책을 먼저 확인해야 합니다.
반대로 HTTP 응답 자체가 오지 않고 timeout이 발생한다면 Gateway 이후의 처리 지연이나 네트워크 경로를 추가로 살펴볼 필요가 있습니다.
4단계. TLS 핸드셰이크와 연결 재사용을 확인한다
HTTPS 기반 REST API에서는 TLS 연결 과정이 추가됩니다.
특히 새로운 TCP 연결을 반복적으로 생성하면 연결 과정에서 추가적인 네트워크 작업과 TLS 핸드셰이크가 발생할 수 있습니다.
cURL에서는 다음 값을 이용해 해당 구간을 측정할 수 있습니다.
time_connect
time_appconnecttime_connect는 TCP 연결까지 걸린 시간을, time_appconnect는 SSL/TLS 등의 보안 연결이 완료되기까지 걸린 시간을 의미합니다.
따라서 다음과 같이 구간별 시간을 비교해볼 수 있습니다.
DNS        0.02초
TCP        0.05초
TLS        0.08초
TTFB       4.50초
TOTAL      4.70초
이런 결과라면 TLS 자체가 주요 병목이라고 보기보다는 TLS 이후 첫 응답까지 걸리는 시간이 긴 이유를 조사하는 것이 우선입니다.
반대로 새로운 연결이 반복적으로 만들어지는 구조라면 커넥션 재사용이나 Connection Pool 적용 여부도 확인할 수 있습니다.
API 호출량이 많은 서비스에서는 이러한 연결 관리가 전체적인 네트워크 효율에 영향을 줄 수 있습니다.
5단계. Retry와 Exponential Backoff를 적용한다
네트워크 환경에서는 모든 timeout을 완벽하게 제거하기 어렵습니다.
일시적인 네트워크 장애나 서버 부하, Gateway 장애 등이 발생할 수 있기 때문입니다.
이런 상황에서는 재시도(Retry) 전략을 설계할 필요가 있습니다.
하지만 timeout이 발생했다고 즉시 무한정 재시도하면 오히려 문제가 커질 수 있습니다.
예를 들어 수천 개의 클라이언트가 동시에 재시도를 반복하면 이미 부하가 높은 서버에 추가적인 요청이 몰리는 상황이 발생할 수 있습니다.
이를 방지하기 위해 일반적으로 Exponential Backoff 방식을 활용합니다.
예를 들어:
1차 실패 → 1초 대기
2차 실패 → 2초 대기
3차 실패 → 4초 대기
4차 실패 → 8초 대기
같은 방식입니다.
실제 cURL 역시 --retry를 사용할 경우 transient error에 대한 재시도 과정에서 대기시간을 점진적으로 늘리는 방식을 사용합니다. 공식 문서에 따르면 timeout, HTTP 408·429·500·502·503·504 등 일부 상황이 재시도 대상에 포함되며, 기본 재시도 간격도 점진적으로 증가합니다.
예를 들어 다음과 같이 사용할 수 있습니다.
curl --retry 3 \
     --retry-max-time 30 \
     --max-time 10 \
     https://api.example.com/data
다만 모든 API 요청을 무조건 재시도해서는 안 됩니다.
특히 계좌이체, 주문, 결제 등 동일 요청이 반복되면 부작용이 발생할 수 있는 API는 Idempotency-Key 등의 중복 실행 방지 설계를 함께 고려해야 합니다.
cURL 28을 만났다면 이렇게 확인하자
실무에서는 다음 순서로 점검하면 원인을 좁히는 데 도움이 됩니다.
① cURL timeout 설정 확인
curl --connect-timeout 5 --max-time 30 https://api.example.com현재 --connect-timeout과 --max-time이 어떻게 설정되어 있는지 확인합니다. --connect-timeout은 연결 단계, --max-time은 개별 전송의 최대 시간을 제한합니다.
② 구간별 시간을 측정
curl -o /dev/null -s -w \
"DNS:%{time_namelookup}\nTCP:%{time_connect}\nTLS:%{time_appconnect}\nTTFB:%{time_starttransfer}\nTOTAL:%{time_total}\n" \
https://api.example.com
③ DNS 확인
nslookup api.example.comKubernetes라면:
kubectl exec -it <pod-name> -- nslookup api.example.com④ OAG 로그 확인
- Request ID
- HTTP Status
- Gateway 처리시간
- Rate Limit
- Backend 연결시간
- Queue 대기시간
등을 함께 확인합니다.
⑤ Backend 로그 확인
Gateway에서 요청을 정상적으로 전달했는데 응답이 늦다면 백엔드 애플리케이션의 처리시간을 확인합니다.
특히 다음과 같은 영역을 확인할 수 있습니다.
- DB 쿼리
- 외부 API 호출
- AI 모델 추론
- 파일 처리
- 메시지 큐
- 다른 마이크로서비스 호출
cURL 28과 HTTP 오류를 구분해야 하는 이유
개발 과정에서 흔히 발생하는 실수 중 하나는 모든 API 장애를 HTTP 오류로만 보는 것입니다.
예를 들어:
HTTP 500
→ 서버가 내부적인 오류를 반환했다는 의미
HTTP 502
→ Gateway 또는 프록시가 상위 서버로부터 유효하지 않은 응답을 받은 상황
HTTP 429
→ 너무 많은 요청을 받아 제한된 상황
반면
cURL 28
→ cURL 측에서 설정된 timeout 조건에 도달했다는 의미
입니다.
따라서 curl: (28)이라는 메시지만 보고 서버 장애라고 결론 내리기보다는 HTTP 응답이 아예 도착했는지, 도착했다면 어떤 상태 코드였는지부터 구분하는 것이 중요합니다.
AI 시대에 API 네트워크 디버깅이 더 중요해지는 이유
AI 서비스가 확대되면서 API 통신의 중요성도 커지고 있습니다.
AI 모델을 애플리케이션에 연결하거나, 금융 데이터를 가져오거나, 여러 서비스를 하나의 플랫폼에서 연결하는 과정에서 API Gateway와 마이크로서비스 구조가 활용될 수 있기 때문입니다.
특히 AI 추론 API는 일반적인 CRUD API보다 응답시간이 길어질 가능성이 있습니다.
예를 들어:
사용자 → 애플리케이션 → OAG → AI API → 모델 추론 → 데이터 조회 → 응답
과 같은 구조에서는 단순히 네트워크 속도만 확인해서는 문제를 해결하기 어렵습니다.
이때 time_starttransfer와 time_total을 비교하고 Gateway 및 백엔드 로그의 Request ID를 연결하면 어느 구간에서 시간이 증가했는지를 훨씬 쉽게 추적할 수 있습니다.
결국 API 운영에서 중요한 것은 단순히 “평균 응답속도가 빠르다”는 것이 아니라 실패가 발생했을 때 원인을 빠르게 찾고 안정적으로 복구할 수 있는 구조를 만드는 것입니다.
News1608 Editor’s Note
API 연동 시스템의 완성도는 정상적으로 작동할 때만 결정되지 않습니다.
실제 운영 환경에서는 순간적인 트래픽 증가, DNS 지연, 네트워크 장애, Gateway 정책, 백엔드 처리 지연 등 다양한 문제가 동시에 발생할 수 있습니다.
특히 cURL 28 같은 timeout 오류는 하나의 원인으로 설명하기 어렵기 때문에 DNS → TCP → TLS → Gateway → Backend라는 통신 경로를 단계별로 분리해서 확인하는 접근법이 중요합니다.
가장 먼저 해야 할 일은 “서버가 죽었나?”를 추측하는 것이 아니라 어디까지 통신이 진행됐는지 숫자로 확인하는 것입니다.
time_namelookup, time_connect, time_appconnect, time_starttransfer, time_total을 활용하면 네트워크와 애플리케이션 사이의 경계를 보다 명확하게 구분할 수 있습니다.
AI와 금융 API가 더욱 복잡해질수록 이러한 관측 가능성(Observability)과 장애 대응 설계의 중요성도 커질 것으로 보입니다.
참고자료
cURL 공식 문서
cURL 공식 Error Codes — CURLE_OPERATION_TIMEDOUT
cURL 공식 사용 설명서 — timeout·retry·write-out
Kubernetes 공식 문서
투자 및 기술 정보 유의사항
본 콘텐츠는 REST API, cURL, API Gateway 및 Kubernetes 네트워크 환경에 대한 기술적 정보와 일반적인 디버깅 방법을 설명하기 위한 자료입니다. 실제 장애 원인과 해결 방법은 각 기업의 네트워크 구성, API Gateway 제품, 클라우드 환경, 보안정책 및 애플리케이션 구조에 따라 달라질 수 있습니다. 운영 환경에 설정을 변경하기 전에는 해당 시스템의 담당자와 변경 영향을 확인해야 합니다.