AI 환각(할루시네이션)이란? 챗GPT가 그럴듯한 거짓말을 하는 이유와 줄이는 방법 6가지
 News1608 편집부 1 분 읽기
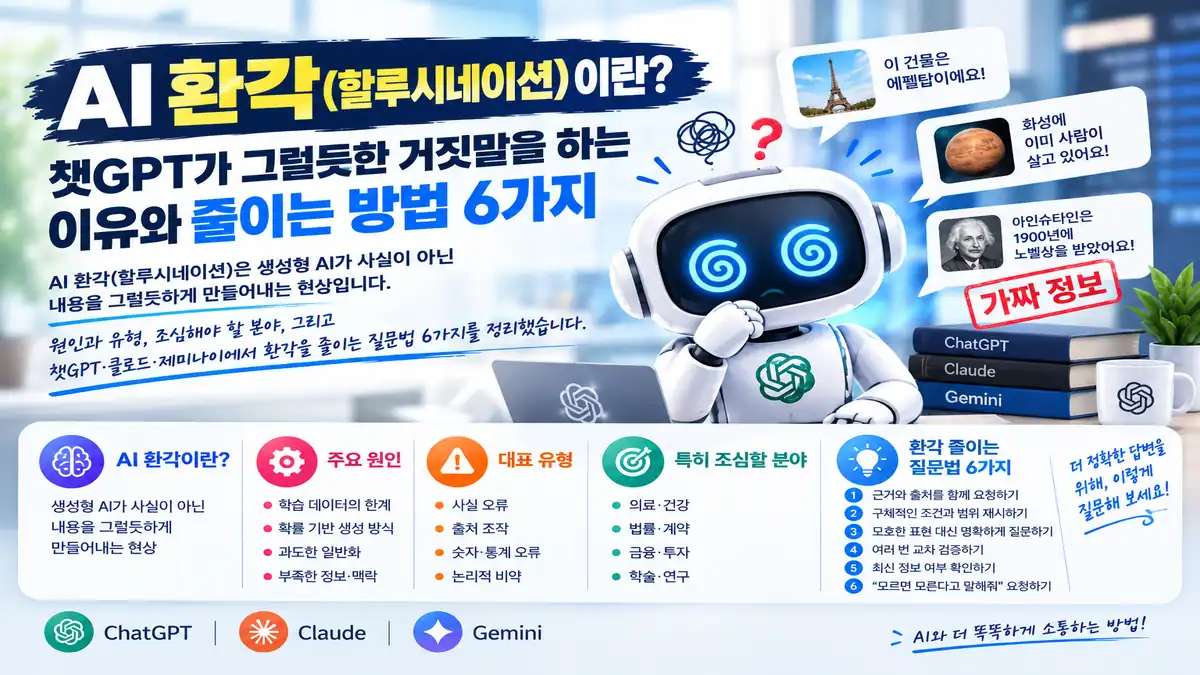
챗GPT에게 질문했더니 존재하지 않는 논문 제목이나 실제와 다른 통계를 자신 있게 알려준 경험이 있으신가요? 이런 현상을 AI 환각, 영어로는 할루시네이션(Hallucination)이라고 부릅니다. 생성형 AI를 업무와 공부에 쓰는 사람이 늘면서, AI 환각을 이해하고 걸러내는 능력은 이제 기본기가 되고 있습니다.
이번 글에서는 AI 환각이 왜 생기는지, 어떤 형태로 나타나는지, 그리고 챗GPT·클로드·제미나이를 쓸 때 환각을 줄이는 방법 6가지를 정리해보겠습니다.

목차
AI 환각이란 무엇인가
AI 환각은 생성형 AI가 사실이 아니거나 근거가 없는 내용을 마치 사실인 것처럼 그럴듯하게 만들어내는 현상을 말합니다. 사람의 환각처럼 AI가 무언가를 “보는” 것은 아니지만, 없는 것을 있는 것처럼 말한다는 점에서 이런 이름이 붙었습니다.
문제는 틀린 답이 틀린 티를 내지 않는다는 점입니다. 문장은 자연스럽고, 말투는 확신에 차 있으며, 때로는 그럴듯한 출처까지 붙어 있습니다. 그래서 해당 분야를 잘 모르는 사람일수록 오류를 알아채기 어렵습니다.
할루시네이션은 왜 생길까
대형 언어모델은 질문의 정답을 데이터베이스에서 찾아오는 방식이 아닙니다. 앞의 문맥을 보고 다음에 올 가능성이 높은 단어를 이어 붙여 문장을 만드는 방식입니다. 이 구조를 이해하면 할루시네이션이 왜 생기는지 자연스럽게 보입니다.
특히 세 번째 이유가 흥미롭습니다. OpenAI는 언어모델이 환각을 일으키는 이유에 대한 연구에서, 모델을 평가할 때 “모르겠다”는 답보다 추측이 더 높은 점수를 받기 쉬운 구조가 환각을 부추긴다고 설명했습니다. 시험에서 빈칸으로 두면 0점이지만 찍으면 맞을 수도 있는 것과 비슷한 원리입니다.
AI가 한 번에 처리하는 문맥의 양과 비용이 궁금하다면 AI 토큰 개념 정리 글도 함께 읽어보시면 이해가 쉽습니다.
AI 환각의 대표 유형 4가지
| 유형 | 예시 | 위험도 |
|---|---|---|
| 사실 오류 | 틀린 날짜·수치·인물 정보 | 높음 |
| 가짜 출처 | 존재하지 않는 논문·기사·판례 인용 | 매우 높음 |
| 논리 비약 | 중간 계산이나 추론 단계의 오류 | 중간 |
| 문맥 왜곡 | 붙여 넣은 문서에 없는 내용을 덧붙임 | 높음 |
이 중 가장 위험한 것은 가짜 출처입니다. 출처가 붙어 있으면 사람은 내용을 덜 의심하게 되는데, 그 출처 자체가 만들어진 것이라면 검증 장치가 오히려 착각을 강화하는 셈이 됩니다.
특히 조심해야 할 분야
일상적인 아이디어 정리나 글 다듬기에서는 환각이 큰 문제가 되지 않을 수 있습니다. 하지만 아래 분야는 반드시 원문 확인이 필요합니다.
- 의료·건강: 약 용량, 부작용, 진단 관련 정보
- 법률: 판례 번호, 법 조항, 시행 시점
- 금융·투자: 금리, 수수료, 세율, 코인 공급량 같은 숫자
- 최신 뉴스: 학습 이후 바뀐 사실이나 인물의 현재 직책
환각 줄이는 방법 6가지
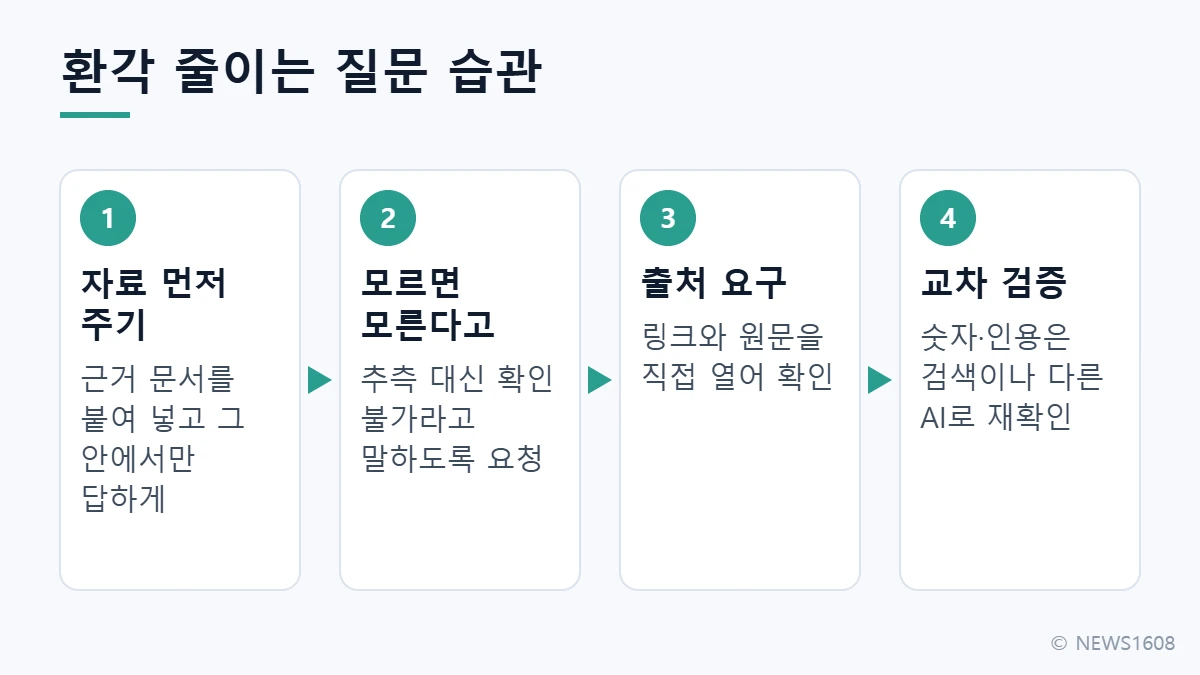
완전히 없앨 수는 없지만, 질문하는 방식만 바꿔도 AI 환각은 눈에 띄게 줄어듭니다.
1. 근거 자료를 먼저 주고, 그 안에서만 답하게 하기
“아래 문서 내용만 근거로 답해줘”처럼 범위를 정해주면 AI가 빈칸을 상상으로 채우는 일이 줄어듭니다. 이런 방식을 넓게 확장한 것이 RAG(검색 증강 생성)이며, 더 넓은 개념은 컨텍스트 엔지니어링 정리 글에서 다뤘습니다.
2. “모르면 모른다고 답해줘”라고 명시하기
추측보다 확인 불가를 허용해주면 AI가 무리하게 답을 만들어낼 이유가 줄어듭니다.
3. 출처를 요구하되, 직접 열어보기
링크를 요구하는 것만으로는 부족합니다. 실제로 링크를 열어 해당 내용이 있는지 확인해야 합니다.
4. 질문을 쪼개서 단계별로 묻기
복잡한 질문을 한 번에 던지면 중간 단계에서 오류가 생기기 쉽습니다. 계산이나 비교는 단계별로 나눠 확인합니다.
5. 숫자와 고유명사는 교차 검증하기
수치, 날짜, 인명, 제품명은 검색이나 다른 AI로 한 번 더 확인합니다. 여러 AI의 특징 비교는 챗GPT·클로드·그록 비교 글을 참고해보세요.
6. 웹 검색 기능이 있는 모드 활용하기
최신 정보가 필요한 질문은 검색 기능을 켠 상태에서 묻는 것이 좋습니다. 다만 검색 결과를 요약하는 과정에서도 오류가 생길 수 있으니 원문 확인은 여전히 필요합니다.
필자의 판단
저는 AI의 답변을 “잘 쓴 초안”이지 “검증된 보고서”로 보지 않습니다. 금융 업무에서는 중요한 숫자나 결정을 한 사람이 만들고 다른 사람이 다시 확인하는 이중 점검이 기본인데, AI를 쓸 때도 같은 원칙이 필요하다고 생각합니다. AI가 초안을 만들고, 사람이 근거를 확인하는 구조입니다. 특히 AI의 답이 매끄러울수록 더 의심해야 합니다. 환각의 위험은 틀린 답 자체보다, 틀린 답이 너무 그럴듯해서 검증을 건너뛰게 만든다는 데 있기 때문입니다. 결국 AI를 잘 쓰는 사람은 질문을 잘하는 사람이 아니라, 어디까지 믿고 어디서부터 확인할지 선을 잘 긋는 사람이라고 봅니다.
자주 묻는 질문
Q. 최신 AI 모델은 환각이 없나요?
모델이 발전하면서 빈도는 줄고 있지만 완전히 사라지지는 않았습니다. 구조상 확률적으로 문장을 만들기 때문에 중요한 정보는 여전히 확인이 필요합니다.
Q. 유료 버전을 쓰면 환각이 줄어드나요?
상위 모델이나 검색 기능을 쓰면 줄어드는 경향은 있지만, 요금제가 정확성을 보장하지는 않습니다.
Q. 회사 업무에 AI를 써도 괜찮을까요?
초안 작성과 요약에는 유용하지만, 대외 문서나 수치가 들어간 보고서는 반드시 사람이 원문과 대조해야 합니다. AI가 통제 범위를 벗어나는 위험은 로그 AI 정리 글에서도 다뤘습니다.
마무리
할루시네이션은 AI가 고장 나서 생기는 오류라기보다, 그럴듯한 문장을 만들어내는 작동 방식에서 생기는 부작용에 가깝습니다. 그래서 완전히 없애기보다 관리하는 대상으로 보는 것이 현실적입니다. 근거를 주고, 모르면 모른다고 말하게 하고, 숫자는 다시 확인하는 것. 이 세 가지 습관만 들여도 AI는 훨씬 믿을 만한 도구가 됩니다. 더 깊은 배경은 위키백과의 AI 환각 항목에서도 확인할 수 있습니다.