AI 토큰이란? 챗GPT·클로드 요금이 토큰으로 계산되는 이유와 비용 줄이는 방법 5가지

한 줄 요약 — AI 토큰은 AI가 글을 읽고 쓰는 기본 단위입니다. AI는 글자나 단어가 아니라 이 조각 단위로 글을 처리합니다. AI 서비스 요금, 한 번에 넣을 수 있는 문서 분량, 답변이 중간에 끊기는 현상까지 모두 이 토큰으로 설명됩니다.
목차
생성형 AI를 업무에 도입하려고 요금표를 열어보면 대부분 “100만 토큰당 ○달러” 같은 식으로 적혀 있습니다. 글자 수도, 단어 수도, 질문 횟수도 아닌 ‘토큰’이라는 낯선 단위입니다. 중소기업 AI 도입 가이드에서 비용 관리를 강조했던 것도 결국 이 토큰을 얼마나 쓰느냐의 문제로 귀결됩니다. 참고로 여기서 말하는 토큰은 코인 시장의 ‘토큰’과는 전혀 다른 개념입니다. 가상자산 토큰이 궁금하다면 토큰 언락 해설 기사를 참고하세요.
AI 토큰이란? AI가 글을 읽는 ‘조각’ 단위
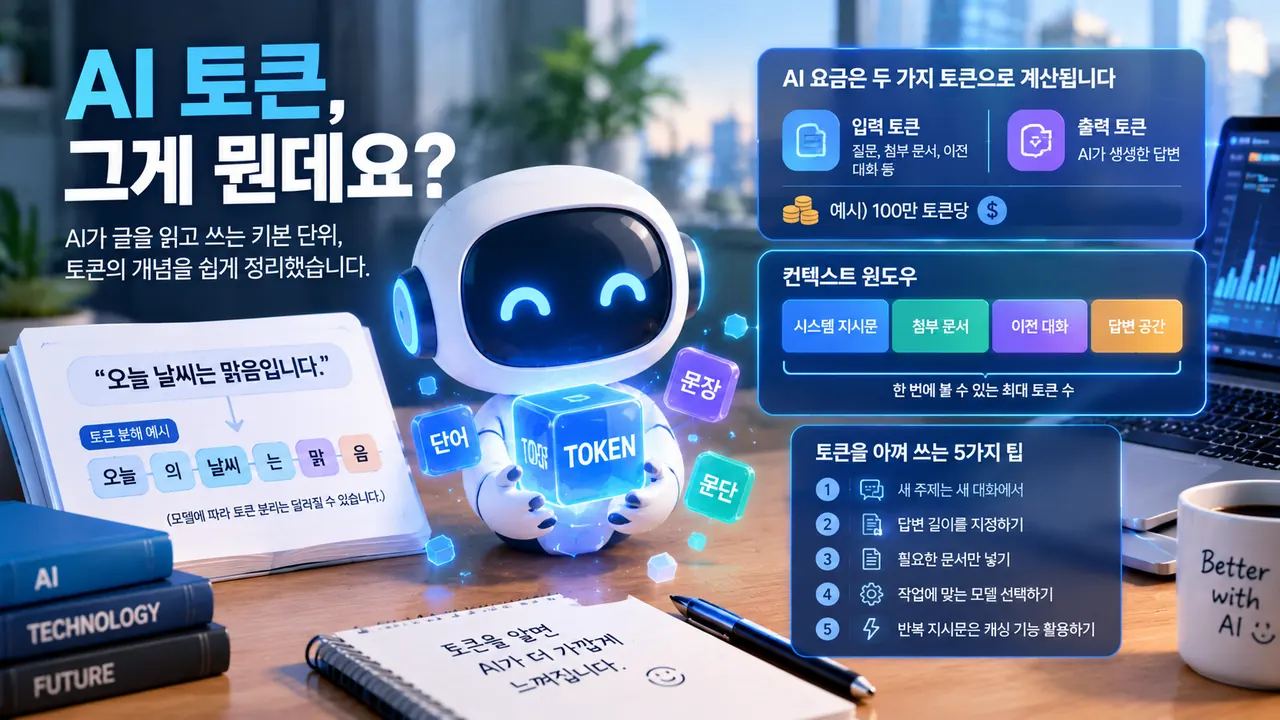
사람은 글을 글자와 단어로 읽지만, 대형언어모델(LLM)은 글을 먼저 자주 등장하는 글자 묶음으로 잘게 쪼갭니다. 이 조각 하나하나가 토큰입니다. 예를 들어 “오늘의 날씨는 맑음”이라는 문장은 모델에 따라 “오늘 / 의 / 날씨 / 는 / 맑 / 음”처럼 여러 조각으로 나뉠 수 있습니다.
왜 굳이 이렇게 쪼갤까요? 모든 단어를 통째로 외우려면 사전이 끝없이 커지고, 반대로 한 글자씩 처리하면 문장이 너무 길어져 계산량이 폭증합니다. 토큰은 그 중간 지점입니다. 자주 쓰는 표현은 한 덩어리로, 드문 표현은 여러 조각으로 나눠 효율과 유연성을 동시에 잡는 방식입니다.
그리고 AI가 답변을 만드는 방식도 토큰 단위입니다. AI는 지금까지의 토큰을 보고 “다음에 올 가장 그럴듯한 토큰”을 하나 예측해 붙이고, 그 결과를 다시 보고 다음 토큰을 예측하는 과정을 반복합니다. 채팅 화면에서 답변이 한 글자씩 흘러나오듯 보이는 이유가 여기에 있습니다.
한국어는 토큰을 더 많이 쓸까?
대체로 그렇습니다. AI 모델은 영어 데이터로 가장 많이 학습되기 때문에 영어 표현을 큰 덩어리로 묶는 데 유리합니다. 영어는 흔히 “토큰 1개 ≈ 영단어 4분의 3개” 정도로 설명되지만, 한국어는 같은 의미를 담는 데 더 많은 토큰이 드는 경우가 많습니다.
다만 이 차이는 모델마다, 그리고 모델 세대마다 다릅니다. 최근 모델들은 다국어 처리를 개선하면서 한국어 효율도 좋아지는 추세입니다. 중요한 것은 “같은 내용이라도 언어와 모델에 따라 비용이 달라질 수 있다”는 점을 알고, 실제 업무 문서로 직접 측정해 보는 것입니다. 대부분의 AI 개발사는 입력한 글이 몇 토큰인지 세어 주는 도구를 제공합니다. OpenAI는 웹에서 바로 써볼 수 있는 토크나이저를, Anthropic은 메시지를 보내기 전에 토큰 수를 미리 계산하는 토큰 카운팅 기능을 공개하고 있습니다.
AI 토큰 요금 계산법: 입력 토큰과 출력 토큰
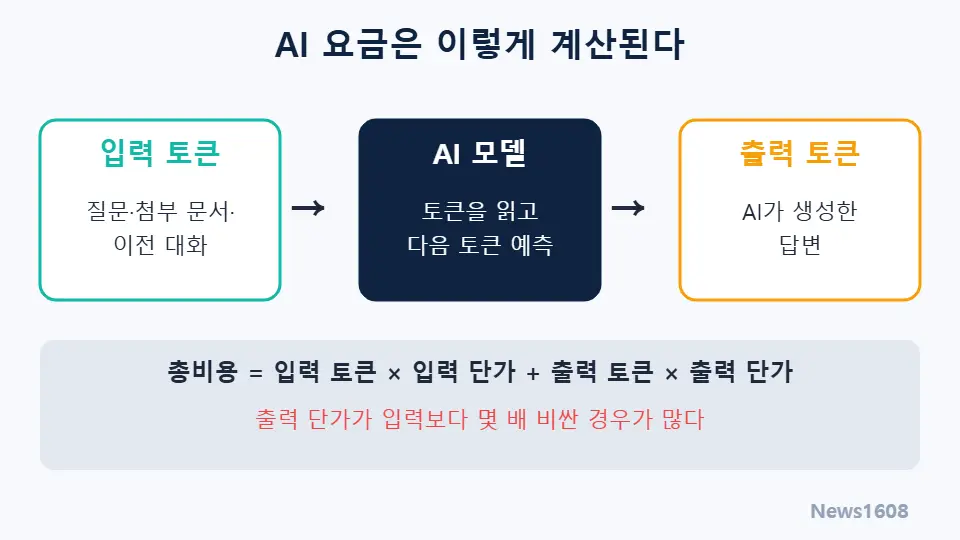
API 방식으로 AI를 쓸 때 비용은 크게 두 부분으로 나뉩니다.
- 입력 토큰: 내가 보낸 질문, 첨부한 문서, 시스템 지시문, 그리고 이전 대화 내용 전체
- 출력 토큰: AI가 생성한 답변
여기서 많은 사람이 놓치는 두 가지가 있습니다. 첫째, 출력 토큰 단가가 입력 토큰보다 몇 배 비싼 경우가 많습니다. 새로운 토큰을 하나씩 만들어내는 작업이 읽는 작업보다 계산 부담이 크기 때문입니다. 둘째, 대화가 길어질수록 AI는 매번 앞의 대화를 다시 읽어야 하므로 입력 토큰이 눈덩이처럼 불어납니다. 열 번째 질문을 보낼 때는 앞선 아홉 번의 질문과 답변이 모두 입력 토큰으로 다시 계산되는 셈입니다.
컨텍스트 윈도우: AI가 한 번에 볼 수 있는 ‘책상 크기’
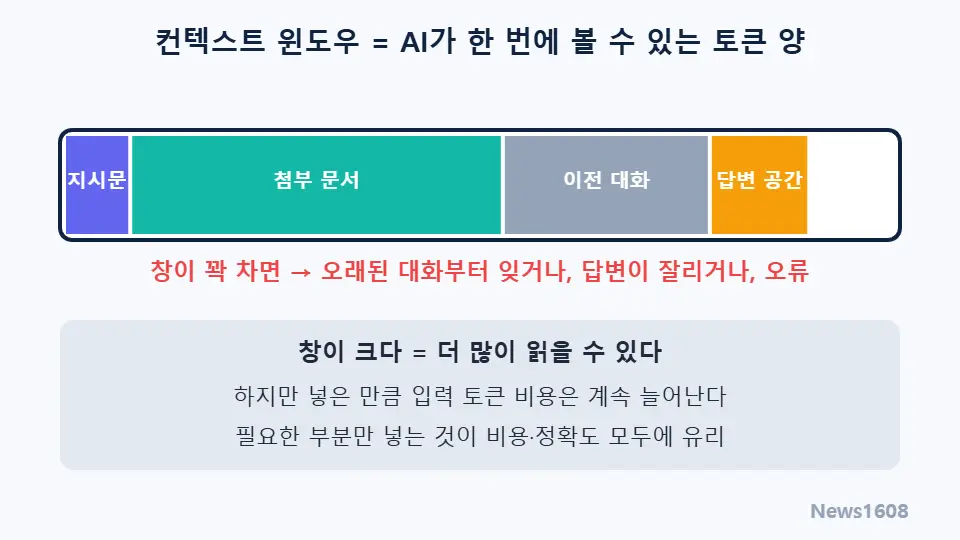
컨텍스트 윈도우는 AI가 한 번에 처리할 수 있는 토큰의 최대치입니다. 책상 크기에 비유하면 쉽습니다. 책상이 넓을수록 긴 보고서나 여러 문서를 한꺼번에 펼쳐 놓고 볼 수 있습니다. 지시문, 첨부 문서, 이전 대화, 그리고 AI가 쓸 답변 공간까지 모두 이 책상 위에 올라가야 합니다.
책상이 꽉 차면 문제가 생깁니다. 서비스에 따라 오래된 대화를 잘라내거나 요약하기도 하고, 답변이 중간에 끊기기도 하며, 아예 오류가 나기도 합니다. “처음에 말한 조건을 AI가 잊어버렸다”는 경험의 상당수가 이 때문입니다.
컨텍스트 윈도우가 크다는 것은 분명 장점이지만, 넣은 만큼 입력 토큰 비용이 늘어난다는 점도 기억해야 합니다. 또 문서를 너무 많이 넣으면 정작 중요한 부분을 놓치는 경우도 있어, “다 넣기”보다 “필요한 부분만 넣기”가 비용과 정확도 모두에 유리한 경우가 많습니다.
토큰이 AI 산업 전체의 ‘화폐’가 된 이유
토큰은 단순한 과금 단위를 넘어 AI 산업의 기본 계량 단위가 됐습니다. AI 기업은 “초당 몇 토큰을 생성하느냐”로 서비스 속도를 비교하고, 데이터센터와 반도체 업계는 “토큰 하나를 만드는 데 드는 전력과 비용”을 줄이는 경쟁을 벌입니다. AI 데이터센터 투자와 HBM 공급 부족 이슈도 결국 더 많은 토큰을 더 싸고 빠르게 만들기 위한 인프라 경쟁이라고 볼 수 있습니다.
반대로 온디바이스 AI는 토큰 생성을 클라우드가 아닌 스마트폰 안에서 처리하는 방식입니다. 토큰당 과금이 없는 대신, 기기 성능이 허락하는 작은 모델만 돌릴 수 있다는 트레이드오프가 있습니다.
AI 토큰 비용을 줄이는 실전 팁 5가지
- 새 주제는 새 대화에서: 긴 대화를 이어가면 앞의 내용이 계속 입력 토큰으로 쌓입니다.
- 답변 길이를 지정: “3문장으로”, “표 하나로”처럼 출력 분량을 정하면 비싼 출력 토큰을 아낄 수 있습니다.
- 문서는 필요한 부분만: 100쪽 보고서 전체보다 관련 장만 넣는 것이 저렴하고 정확합니다.
- 작업에 맞는 모델 선택: 단순 분류·요약은 작고 저렴한 모델로도 충분한 경우가 많습니다.
- 반복되는 지시문은 재사용 기능 활용: 일부 서비스는 반복 입력되는 내용을 저렴하게 처리하는 캐싱 기능을 제공합니다(예: Claude 프롬프트 캐싱 문서).
기업 현장에서 AI 프로젝트가 기대만큼 성과를 내지 못하는 이유 중 하나도 예상보다 커진 운영비입니다. 기업 AI 도입 실패 요인을 점검할 때 토큰 사용량 모니터링을 함께 넣어 두면 비용 폭주를 미리 막을 수 있습니다.
자주 묻는 질문(FAQ)
Q. 챗GPT·클로드 같은 월정액 서비스도 토큰을 따지나요?
월정액 사용자는 토큰당 요금을 직접 내지 않지만, 내부적으로는 사용량 한도가 토큰이나 메시지 기준으로 관리되는 경우가 많습니다. 긴 문서를 자주 넣으면 한도에 더 빨리 도달하는 이유입니다.
Q. 토큰 수를 미리 알 수 있나요?
대부분의 AI 개발사가 토큰 계산 도구나 API 기능을 제공합니다. 모델마다 토큰을 나누는 방식이 달라, 같은 글도 모델에 따라 토큰 수가 다를 수 있습니다.
Q. 컨텍스트 윈도우가 크면 무조건 좋은 모델인가요?
긴 문서를 다룰 수 있다는 장점은 분명하지만, 모델의 추론 품질이나 비용과는 별개의 문제입니다. 용도에 맞게 비교해야 합니다.
정리: AI 시대의 새로운 계량 단위
전기를 kWh로, 데이터를 GB로 재듯 AI는 토큰으로 잽니다. 토큰의 개념을 이해하면 AI 요금표가 읽히고, AI가 긴 대화에서 앞의 내용을 잊는 이유가 보이며, 업무에 AI를 도입할 때 비용을 설계할 수 있게 됩니다. AI를 ‘잘 쓰는’ 첫걸음은 결국 토큰을 ‘아껴 쓰는’ 감각에서 시작됩니다.
함께 읽으면 좋은 글